반응형
데이터 분석을 시작할 때, Python의 강력한 라이브러리인 Pandas와 PyDataset을 활용하면 효율적으로 데이터를 다룰 수 있습니다. 이번 에는 간단한 예제를 통해 Pandas와 PyDataset을 사용하는 방법을 소개하겠습니다.
1. Pandas와 PyDataset 설치
먼저, Pandas와 PyDataset을 설치합니다. 터미널에서 다음 명령어를 실행하세요:
pip install pandas pydataset

2. 라이브러리 임포트
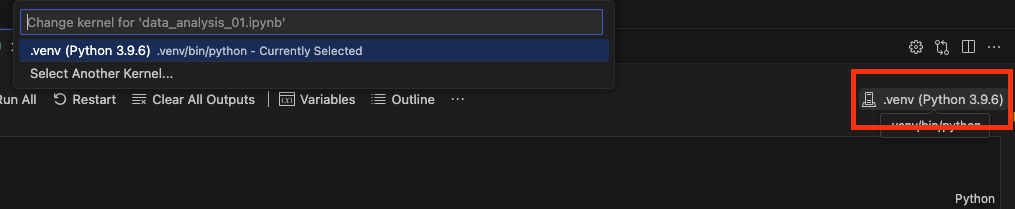
설치가 완료되면, Jupyter Notebook에서 다음과 같이 'venv' 환경을 선택하고, 라이브러리를 임포트합니다:
import pandas as pd
import pydataset			# 여러가지 데이터 셋 패키지
3. 데이터셋 로드
PyDataset은 다양한 내장 데이터셋을 제공합니다. 예를 들어, 'mtcars' 데이터셋을 로드 해보겠습니다:
df = pydataset.data('mtcars')
4. 데이터 확인
로드한 데이터셋을 확인하려면 head() 메서드를 사용합니다:
print(df.head())

5. 데이터 분석
이제 Pandas를 사용하여 간단한 데이터 분석을 수행할 수 있습니다. 예를 들어, 각 자동차의 최소, 최대, 평균 연비를 계산해보겠습니다:
average_mpg = df['mpg'].mean()
min_mpg = df['mpg'].min()
max_mpg = df['mpg'].max()

print(f"평균 연비: {average_mpg}")
print(f"최소 연비: {min_mpg}")
print(f"최대 연비: {max_mpg}")

이렇게 조금씩 하나씩 실습해보면서 익혀가는게 쉽고, 보고자 하는 데이터를 쉽게 이해할 수 있어 좋습니다!